Analitika Data
- Pembersihan data (Data Cleansing)
- Eksplorasi data (EDA)
- Peramalan deret waktu (Time-Series)
Tukang tarot yang bisa analisis data sektor publik
Haloo! Aku Faiz, di sini aku lagi belajar gimana cara membuat projek menggunakan AI. Aku bisa menganalisis data sektor publik seperti membuat prediksi atau melakukan time-series. Selain itu, aku bisa meramal menggunakan kartu tarot lhoo hehe
Kombinasi kemampuan analitis kuantitatif, penguasaan perkakas, dan kecakapan komunikasi.
Kajian pemodelan berbasis data kuantitatif pada sektor publik dan studi kasus nyata.
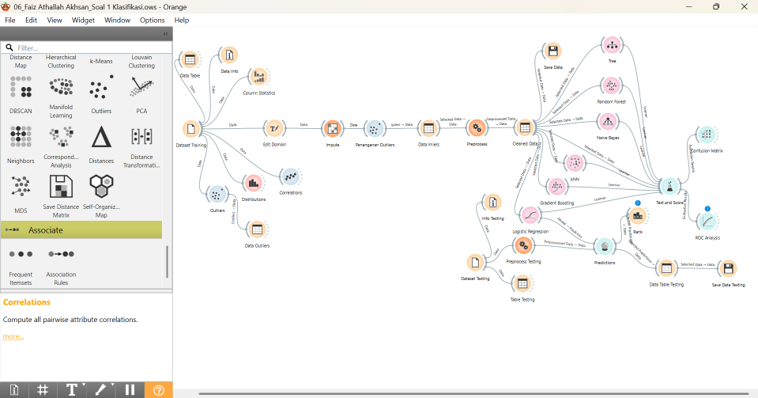
Pengeluaran dan pendapatan instansi sektor publik sering kali terkendala oleh inkonsistensi penulisan data dan pencilan (outliers) yang tinggi. Hal ini menyulitkan penetapan status risiko organisasi secara akurat untuk pengawasan keuangan.
Dataset: Dataset Status Risiko Organisasi (500 baris instances, 7 fitur utama termasuk variabel kategorik dan numerik keuangan).
Metode: Prapemrosesan data (Simple Tree Imputer, deteksi pencilan Local Outlier Factor k=20, Normalisasi) dan Klasifikasi (Logistic Regression, Random Forest, Decision Tree, Naive Bayes).
Pemodelan Logistic Regression berbasis prapemrosesan LOF efektif dalam memetakan tingkat risiko organisasi untuk efisiensi pengawasan.
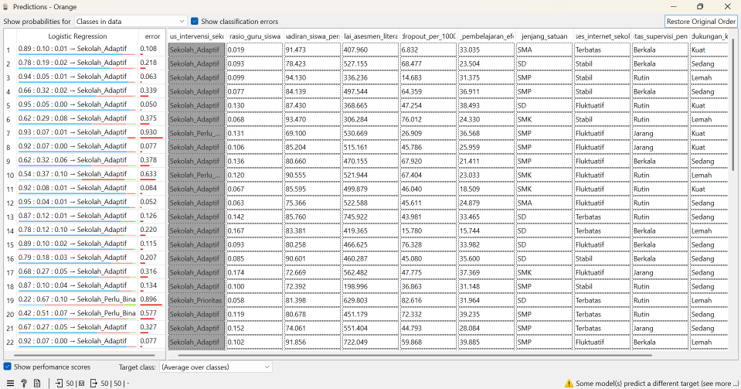
Penentuan bantuan prioritas pendidikan sering terhambat akibat data kosong (missing values) yang mencapai 7,3% dan ketidakseragaman input nama jenjang sekolah. Masalah ketidakseimbangan kelas target (data imbalance) juga berpotensi memicu bias pada klasifikasi kebijakan.
Dataset: Dataset Intervensi Sekolah (950 baris, 11 kolom atribut kategorik dan numerik).
Metode: Data Cleansing (Edit Domain, Formula, Impute Average/Most Frequent, LOF Outlier Removal) dan Klasifikasi (Logistic Regression, Naive Bayes, kNN).
Integrasi pemodelan klasifikasi terbukti efektif mengelompokkan sekolah ke dalam kategori adaptif, perlu bina, dan prioritas guna optimalisasi alokasi bantuan pemerintah.
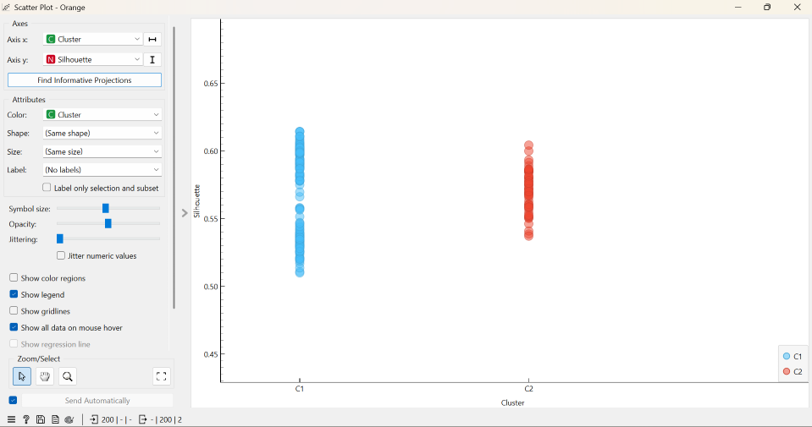
Pola aktivitas harian seperti jam belajar, waktu tidur, dan durasi penggunaan media sosial memiliki keterkaitan kompleks terhadap Indeks Prestasi Kumulatif (IPK) mahasiswa. Tanpa pengelompokan yang terstruktur, perancangan program pembinaan akademik menjadi kurang tepat sasaran.
Dataset: Dataset Produktivitas Mahasiswa (Modified_Student_Productivity.csv, variabel jam belajar, tidur, IPK, kehadiran).
Metode: Prapemrosesan Imputation & Normalization, serta Pemodelan Klustering Unsupervised (k-Means, DBSCAN, Hierarchical Clustering).
Algoritma k-Means k=3 berhasil memetakan karakteristik produktivitas mahasiswa secara terstruktur untuk mendukung pembinaan akademis berbasis data.
Dapatkan ringkasan lengkap kualifikasi, riwayat pendidikan, dan rekam jejak analitika data saya.
Terbuka untuk diskusi proyek analitika data sektor publik maupun peluang kolaborasi.